Florence-2-Vision-Language-Model
视觉模型对比
| 模型路线 | 核心目标 | 强项 | 弱项 | 适合场景 |
|---|---|---|---|---|
| Microsoft 的 Florence-2 | “理解世界” | 语义理解极强、泛化强、多任务 | 边缘粗、不适合精细像素级 | AI Agent、机器人、大模型视觉入口 |
| Meta 的 Segment Anything Model 2 | “精准抠图” | 边缘极强、视频一致性强 | 重、慢、语义弱 | 医疗、工业、视频后处理 |
| Ultralytics 的 YOLO / YOLO-seg | “实时工业检测” | 超快、部署简单、边缘设备友好 | 泛化差、开放世界能力弱 | 无人车、安防、边缘 AI |
部署 Florence-2-large
环境配置
conda create -n florence-2-large python=3.10

conda activate florence-2-large

pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124

pip install six requests opencv-python-headless -i https://pypi.tuna.tsinghua.edu.cn/simple

pip install einops timm pillow transformers accelerate -i https://pypi.tuna.tsinghua.edu.cn/simple
模型下载
pip install modelscope -i https://pypi.tuna.tsinghua.edu.cn/simple

# 模型
modelscope download --model AI-ModelScope/Florence-2-large --local_dir ./model-large
运行测试脚本
python test_florence_scene.py --image test_scene_720p.jpg --model model-large --output_dir outputs --max_segments 3

python test_florence_scene.py --image test_scene_1280x1280.jpg --model model-large --output_dir outputs --fast

# 增加识别目标
python test_florence_scene.py --image test_scene_1280x1280.jpg --model model-large --output_dir outputs --max_segments 20 --od_tokens 384 --dense_region_tokens 384 --seg_tokens 512
运行结果
(florence-2-large) xt@xt-2288H-V5:~/lixiaogang/Florence-2-large$ python test_florence_scene.py --image test_scene_1280x1280.jpg --model model-large --output_dir outputs --max_segments 20 --od_tokens 384 --dense_region_tokens 384 --seg_tokens 512
[INFO] 当前运行参数:
{
  "fast_mode": false,
  "image": "test_scene_1280x1280.jpg",
  "model": "model-large",
  "output_dir": "outputs",
  "exhaustive": false,
  "max_segments": 20,
  "caption_tokens": 64,
  "detailed_caption_tokens": 96,
  "od_tokens": 384,
  "dense_region_tokens": 384,
  "seg_tokens": 512,
  "proposal_tokens": 256,
  "region_to_category_tokens": 48,
  "max_proposals_classify": 20,
  "iou_dedup": 0.6
}
[INFO] 开始加载图片: test_scene_1280x1280.jpg
[INFO] 图片预处理完成: 1280x1280 -> 1280x1280, 耗时 0.020 秒
[INFO] 开始从本地目录加载模型: model-large
[INFO] 模型加载完成, Device: cuda:0, dtype: torch.float16, 耗时 1.852 秒
[INFO] 开始语义理解任务推理...
[TIME] <CAPTION> 耗时: 2.473 秒
[TIME] <DETAILED_CAPTION> 耗时: 0.616 秒
[TIME] <OD> 耗时: 0.389 秒
[TIME] <DENSE_REGION_CAPTION> 耗时: 0.337 秒
[TIME] 语义理解总耗时: 3.815 秒
[INFO] 联合 Prompt 融合: OD标签 5 条, Dense标签 4 条
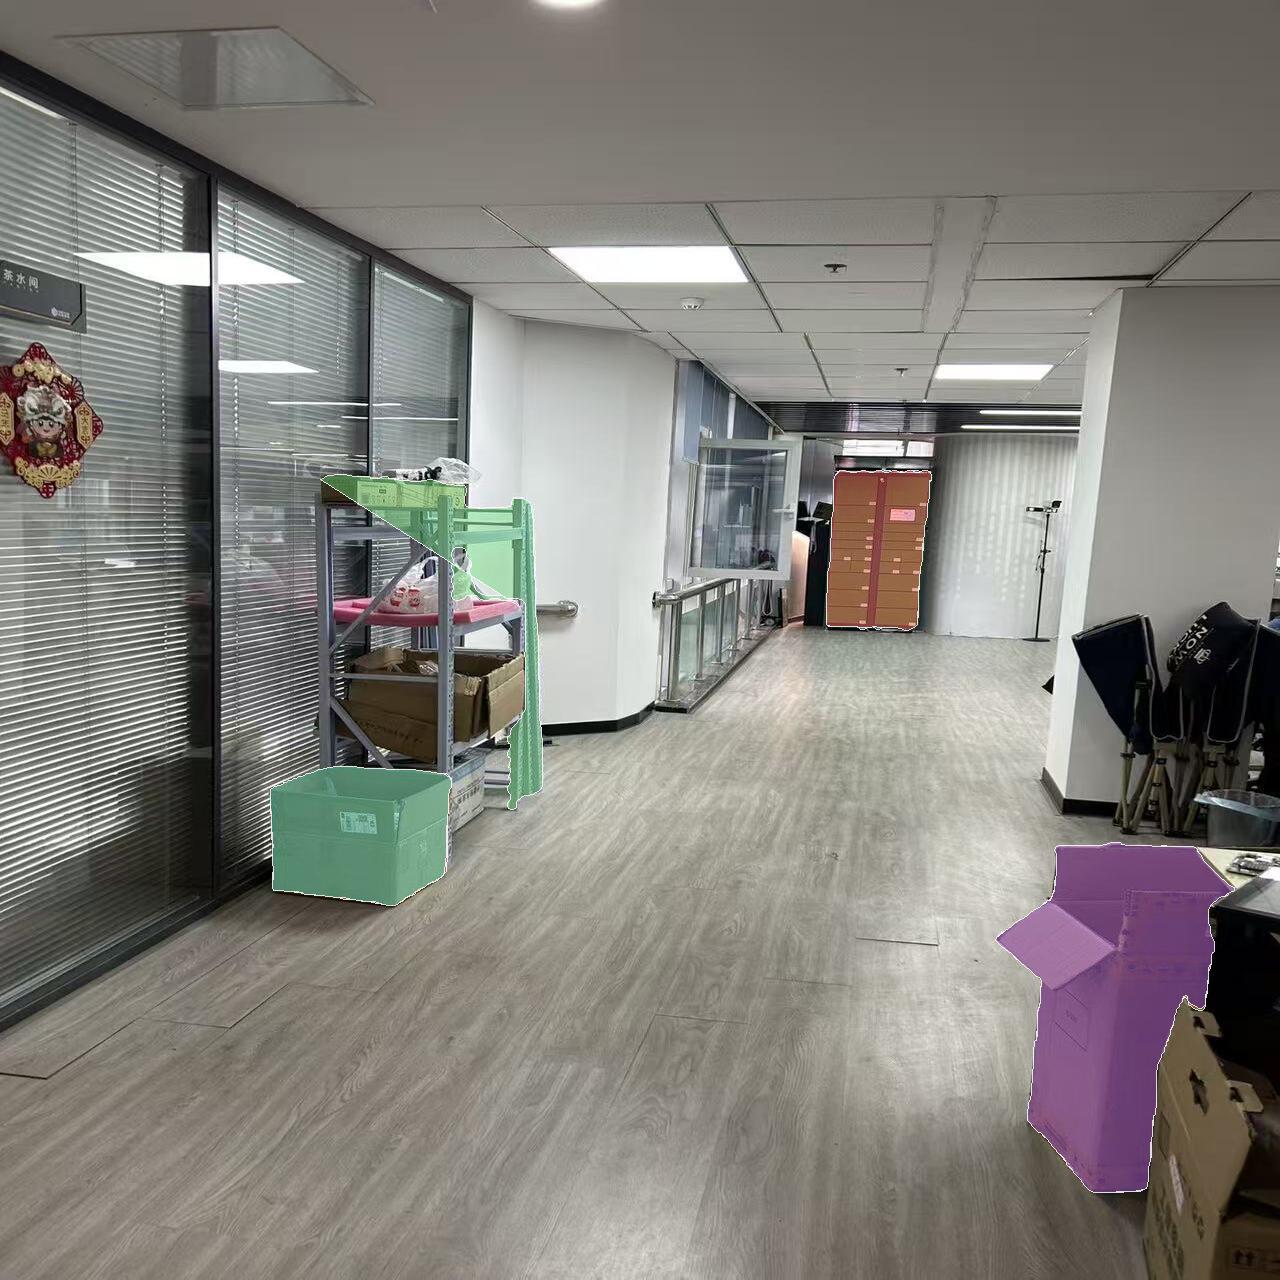
[INFO] 分割目标类别: ['box', 'door', 'shelf', 'cardboard boxes', 'boxes', 'cardboard box with shipping label in warehouse', 'warehouse']
[TIME] 分割目标 'box' 耗时: 2.303 秒
[TIME] 分割目标 'door' 耗时: 1.912 秒
[TIME] 分割目标 'shelf' 耗时: 5.917 秒
[TIME] 分割目标 'cardboard boxes' 耗时: 4.537 秒
[TIME] 分割目标 'boxes' 耗时: 4.447 秒
[TIME] 分割目标 'cardboard box with shipping label in warehouse' 耗时: 2.172 秒
[TIME] 分割目标 'warehouse' 耗时: 2.133 秒
[TIME] 像素分割总耗时: 23.421 秒
[TIME] 结果保存与可视化耗时: 0.022 秒
[DONE] JSON result: outputs/test_scene_1280x1280_florence_result.json
[DONE] Segmentation overlay: outputs/test_scene_1280x1280_seg_overlay.jpg
[TIME] 全流程总耗时: 29.132 秒
当前问题
segmentation 极慢
| 模块 | 耗时 |
|---|---|
| Caption + OD + Dense | 3.8s |
| Segmentation | 23.4s |
| 总耗时 | 29.1s |
根本原因 Florence-2 的 segmentation:
- 不是:直接输出 mask
- 而是:autoregressive polygon token generation
即:一个 token 一个 token 地生成边界点
因此:复杂物体 = token 爆炸
| 类别 | 耗时 |
|---|---|
| box | 2.3s |
| shelf | 5.9s |
| warehouse | 2.1s |
为什么Florence-2的语义识别只能识别出一部分物体
Florence-2 的语义识别并非“看不见”物体,而是受限于其训练机制、任务模式以及推理时的阈值设定。
| 模块 | 作用 |
|---|---|
<CAPTION> |
全局语义 |
<DETAILED_CAPTION> |
细粒度场景描述 |
<OD> |
目标检测 |
<DENSE_REGION_CAPTION> |
密集区域理解 |
<REGION_PROPOSAL> |
高召回候选区域 |
<REGION_TO_CATEGORY> |
区域分类 |
<REFERRING_EXPRESSION_SEGMENTATION> |
指代表达分割 |
Florence-2 不擅长像素分割
任务模式(Prompt)的选择冲突
Florence-2 是一个多任务模型,不同的指令(Task Prompt)会触发不同的注意力机制:
-
(目标检测): 它倾向于识别数据集中定义过的常见物体(如车、人、路灯)。 -
(密集区域描述): 这个模式下它会尝试找出图中几乎所有的显著物体。如果你只用了 ,它会漏掉很多“它认为不属于标准类别”的东西。 -
(描述): 它只会挑图中最重要的几个物体写成句子,次要物体会被直接忽略。
“显著性”过滤机制
Florence-2 在训练时使用的数据集(FLD-5B)虽然庞大,但它的标注逻辑是基于视觉显著性的。
- 模型会自动过滤掉背景中太小、太模糊或对当前语义不重要的物体。
- 无人配送挑战: 对于车而言,路边一个不起眼的纸箱是致命障碍物,但对于 Florence-2 这种视觉模型,它可能觉得那只是“背景噪音”的一部分。
序列生成的长度限制 (max_new_tokens)
这是一个技术上的硬限制。Florence-2 是通过生成文本(坐标和标签)来完成任务的:
- 模型输出的是一串类似 {“box_2d”: [12, 45, 67, 89], “label”: “car”} 的字符。
- 如果你设置的 max_new_tokens 太小(比如默认的 256 或 512),当图中物体非常多时,模型写到一半“字数超标”了,后面的物体就直接丢弃了。
- 建议: 在复杂路口场景,将 max_new_tokens 提升至 1024 或以上。
训练数据的“长尾分布”
虽然它泛化能力强,但它对非结构化物体的定义依然不够清晰。
- 结构化物体: 车辆、行人、交通标线。模型很有信心。
- 非结构化物体: 洒在路上的沙土、垂落的细铁丝、透明的塑料膜。这些东西在训练数据中很难被一致性地标注,导致模型在推理时即便看到了,也因为“不确定它是什么”而不敢输出。
行业共识
虽然“端到端”(End-to-End)和“全能大模型”在学术论文和发布会上风光无限,但在真正的工业落地——特别是机器人和自动驾驶领域,多模型协同(Modular / Hybrid Pipeline)仍然是铁律。
这背后的逻辑逻辑非常现实,可以归纳为以下几点:
性能的“生命线”:算力与延迟
在自动驾驶或人形机器人领域,延迟不仅仅是体验问题,更是安全问题。
- 实时性要求: 自动驾驶汽车在高速行驶时,处理时间哪怕慢了 50 毫秒,刹车距离就会多出几米。
- 计算效率: 一个巨型 VLM(视觉语言模型)每秒只能跑几帧(FPS),而 Detector(检测器)配合 Tracker(追踪器)可以在嵌入式芯片上轻松跑到 30-60 FPS,且功耗极低。
任务的分工:术业有专攻
目前的技术栈将任务拆解为不同的颗粒度:
- Detector + Tracker(确定“在哪”): 负责高频、高精度的空间定位。它不需要理解“什么是美”,只需要精准捕捉障碍物的坐标和速度。
- Segmentation(确定“边界”): 负责把场景抠出来,告诉机器人哪里是路,哪里是障碍物的边缘。
- VLM(确定“是什么”): 充当“大脑”或“常识库”。它不需要每秒处理 60 次,只需每秒处理 1-2 次,负责理解复杂的语义(例如:“那个小孩正准备冲向马路”或“把那个蓝色的杯子递给我”)。
不考虑视频数据呢,只做图像的语义识别和像素分割
精度与效率的悖论 (Speed vs. Accuracy)
语义识别和像素分割对模型的要求完全不同:
- 语义识别(Classification/VLM): 需要模型具备高层的“抽象能力”。它关注的是“这是什么”,往往会牺牲空间细节来换取深层的语义理解。
- 像素分割(Segmentation): 需要极其精准的“空间坐标”。它关注的是“边缘在哪”,要求保留图像的每一个细节。
Grounded-SAM-2
魔塔社区(ModelScope)作为一个模型库,它的收录逻辑通常是单个模型(如 SAM 2 或 Grounding DINO),而 Grounded-SAM-2 本质上是一个工程仓库/工作流(Pipeline),它把多个模型组合在一起使用。
| 维度 | Grounded-SAM-2(协同派) | “SAM3 类统一派” |
|---|---|---|
| 核心思想 | Detector + Segmentor 解耦 | 统一 Vision-Language-Segmentation |
| 架构 | GroundingDINO + SAM2 | 单模型统一多模态 |
| segmentation方式 | ROI mask decoder | unified semantic decoder |
| 实时性(FPS) | 较高,可接近实时 | 较低 |
| 视频能力 | 强(ROI + tracking) | 通常更重 |
| 边缘端部署 | 相对友好 | 非常困难 |
| 工程成熟度 | 高 | 研究阶段居多 |
| 多目标扩展 | 强 | attention 开销大 |
| 语义理解 | 依赖外部 VLM | 原生更强 |
| Open Vocabulary | 强 | 极强 |
| 推理复杂度 | 分阶段计算 | 全局统一 attention |
| 算力利用率 | 更容易优化 | 更容易爆显存 |
| 系统灵活性 | 很高 | 较低 |
| 开发复杂度 | 多模块协同 | 接口简单但模型复杂 |
| 工业落地 | 很广泛 | 目前较少 |
| 典型场景 | 机器人、IPC、无人车 | 医疗、科研、自动标注 |
groundingdino_swint_sam2_large
groundingdino_swint_sam2_large-魔塔社区
Grounded-SAM-2 vs Florence-2 + SAM2
| 特性 | Grounded-SAM-2(经典协同派) | Florence-2 + SAM2(VLM 新锐派) |
|---|---|---|
| “大脑”模型 | GroundingDINO / DINO-X | Florence-2 |
| 核心能力 | Open-vocab Detection | Unified Vision-Language Understanding |
| 擅长领域 | 目标检测、Grounding | Caption、OCR、语义理解、推理 |
| 输出风格 | bbox-centric | semantic-centric |
| 输入反馈 | text → bbox | text / region / phrase / task token |
| segmentation 配合 | SAM2 ROI | SAM2 ROI |
| 语义理解能力 | 中等 | 极强 |
| 长尾类别 | 强 | 更强 |
| OCR 能力 | 弱 | 极强 |
| Scene Understanding | 一般 | 极强 |
| 多任务统一 | 较弱 | 极强 |
| 推理方式 | 检测优先 | 语言 token 驱动 |
| 模型体量 | 中型 detector | 小到中型 VLM |
| Base 模型规模 | 数亿级 | 230M 起 |
| 边缘部署潜力 | 高 | 很高 |
| 实时性 | 更高 | 中等 |
| 工业成熟度 | 非常成熟 | 正在快速上升 |
| 视频扩展 | 好 | 尚在演进 |
| 典型用途 | 自动标注、机器人感知 | 场景理解、AI IPC、具身智能 |
室内导航
如果说实时 SLAM 是让机器人“现看现走”,那么提前构建语义地图就是给机器人一份带注释的高精度 3D 说明书。
商业公司的实际做法 (Tesla / Waymo / 机器人公司)
虽然大家都在喊“End-to-End”(端到端),但实际部署时:
- 数据采集: 派人或机器人先扫一遍。
- 自动标注: 利用大模型(如你提到的 Grounding DINO + SAM 2 的离线版)自动给地图打标签。
- 地图发布: 机器人下载这份“语义图”后再上岗。
- 增量更新: 机器人上岗后,只需关注地图里“变动”的部分(比如挪动了的椅子),而不需要重新理解整个大楼。
绝大多数国内企业的视觉和语义系统,确实是基于以下这些开源“神作”进行二次开发、修补和工程化的:
- 感知层: 你之前提到的 SAM 2、Grounding DINO、Florence-2 以及 YOLO-World。这些模型提供了基础的“物体分类”和“像素分割”能力。
- SLAM 框架: 国内激光导航公司大量参考了 FAST-LIO2、LIO-SAM 等开源算法;视觉导航则常基于 ORB-SLAM3 或 VINS-Mono。
- 具身智能: 很多公司在做语音指令到动作的映射时,底层用的是 Llama 3 或 Qwen (通义千问) 的开源版本。
企业在开源基础上做了哪些“闭源”工作?
既然底座是开源的,为什么还要买他们的产品?因为从“跑通 Demo”到“工业落地”之间有巨大的工程深渊:
- 硬件适配与加速(硬功夫): 开源模型通常是为 A100 这种显卡设计的,但机器人用的是嵌入式芯片。企业需要做大量的 TensorRT 优化、算子融合和量化(INT8/FP16),让 1 FPS 的模型跑到 20 FPS。
- 长尾数据的积累(护城河): 比如高仙机器人。开源模型能认出“沙发”,但不一定能认出“中式商场特有的深色大理石反光”或“某种新型自动洗地机的残影”。企业通过数万台机器人在前线跑出的私有数据集来微调(Fine-tune)开源模型。
- 失效模式处理: 开源模型崩溃了只会报个错,企业的闭源逻辑要负责:如果视觉被强光晃瞎了,如何切换到激光雷达?如果语义识别错了,如何触发降级机制不撞人?
室内3D导航地图建立步骤
第一阶段:几何建图(不撞墙)
利用 LiDAR 或深度相机(RGB-D)获取环境的 3D 点云或体素地图。
- 输入: 激光雷达点云、IMU 数据、里程计。
- 产出: 3D 点云图或占据网格图(Occupancy Grid)。
第二阶段:语义增强(懂环境)
在几何地图的基础上,利用 VLM 或检测器(如你熟悉的 SAM 2, Florence-2)识别物体并进行 3D 投影。
- 核心: 将 2D 的分割结果与 3D 点云对齐。
- 产出: 带有标签的 3D 物体模型(例如:这个点云簇是一个“沙发”)。
第三阶段:拓扑图构建(会规划)
将物体和空间转化为“点”与“线”的关系图(Scene Graph)。
- 核心: ConceptGraphs 逻辑。它不仅知道沙发在哪,还知道沙发在客厅里,客厅连接着走廊。
- 产出: 供机器人路径规划使用的拓扑地图。
主流开源框架推荐
A. 语义与场景图(大脑级)
ConceptGraphs (IDEA-Research):
特点: 目前最火的开源项目。它使用 SAM / SAM 2 进行开放词汇分割,并将物体通过 CLIP 特征关联。它建立的地图机器人能直接听懂指令。
Hydra (MIT-SPARK):
特点: 实时性极强。它能边走边建立层次化的 3D 场景图(3DSG),支持从“层-房间-物体”的多级导航。
Kimera (MIT):
特点: 这是一个极其完整的 C++ 库,集成了视觉惯性里程计、语义分割和 3D 网格重建。它非常适合追求工业级稳定性的开发者。
基础 SLAM 框架(地基级)
RTAB-Map (Real-Time Appearance-Based Mapping):
地位: 室内导航的“瑞士军刀”。它对 ROS/ROS2 支持极好,支持 RGB-D 摄像头和 LiDAR 融合,自带回环检测,非常适合快速搭建原型。
LIO-SAM / FAST-LIO2:
特点: 激光雷达建图的王者。如果你有 3D 激光雷达(如 Livox 或 Velodyne),这两个方案能提供厘米级的地图精度。
ORB-SLAM3:
特点: 纯视觉建图的最优选,支持单目、双目和 RGB-D。
开源项目 = Nvidia 全家桶
即使到了 2026 年,像 ConceptGraphs 这种顶级项目,如果你不用 Nvidia 的卡,安装过程简直像在“手动通关地狱模式”。这背后有几个非常现实的商业和技术逻辑:
软件生态的“黑洞效应” (CUDA)
- 不仅仅是算力: 大家常说 Nvidia 强在硬件,其实它真正的杀手锏是 CUDA 及其配套的库(如 cuDNN, TensorRT)。
- 开发者的无奈: 当 MIT 或 NVIDIA 的研究员写 ConceptGraphs 时,他们追求的是“快”。调用一个 cuBLAS 函数只需要一行代码,而如果要适配 AMD 或 Intel 的 GPU,他们可能需要额外写几百行底层代码去处理算力分配。
- 结果: 为了快速发论文、出成果,科学家们默认只跑 CUDA。久而久之,所有的开源代码库都长成了 Nvidia 的形状。
机器人硬件的“事实标准” (Jetson)
- 在配送车和机器人领域,Nvidia 的 Jetson (Orin/Thor) 系列几乎垄断了嵌入式算力市场。
- 深度绑定: 配送车需要同时处理 4 路摄像头、2 路激光雷达和实时路径规划。Jetson 的底层驱动(JetPack)已经把驱动、视觉加速、深度学习框架全部打通了。
- 开发者心态: 既然 90% 的原型机器人都在用 Jetson,开源项目自然优先适配 Nvidia。
初创企业进入这个无人配送领域的风险大吗
第一梯队(如九识、新石器、美团、京东)已经跑完了前 20 公里,手里握着大量的路权牌照、海量的运营数据和已经摊薄的硬件成本。
作为初创企业,现在的风险主要集中在以下四个维度:
- 资金与毛利的“死亡之谷”
- 存量市场的“路权”壁垒
- 技术上的“1% 长尾”代价
- 商业模式的“降维打击”
避开这些企业,只做社区或者园区内部配送呢
- 避开牌照死结: 园区内部道路属于物业管理范畴,不属于市政交管局管辖。只要物业允许, 就能上路
- 语义环境更可预测: 相比城市街道,园区的环境相对固定。你可以利用 ConceptGraphs 深度扫描一遍园区,建立极其精细的 3D 语义地图(标注出每一个减速带、每一个快递柜、甚至每一个花坛边缘)。
- 低速 = 高安全性: 园区限速通常在 5-10km/h。在这个速度下,传感器的冗余要求降低,即使系统偶尔“卡顿”或误判,也有足够的物理缓冲时间,风险可控。
这里的核心研发难度在哪里?(不再是 SLAM,而是“琐碎”)
在园区内,配送车面临的是“高频、复杂、非标准化”的小场景挑战:
- 窄路博弈与“潜规则”: 园区里会有违停的私家车、乱放的电动车、成群的小孩。机器人需要理解:这个障碍物是临时的(快递车),还是长期的(石墩)?我该原地等待还是借道绕行?
- 物业与设施的“弱连接”: 最大的技术门槛是“跨越物理障碍”。
- 如何通过园区的门禁系统?(需要集成各类蓝牙/LoRA 模组)。
- 如何进出单元门?(需要与不同品牌的物业系统打通,这需要极强的线下商务落地能力)。
- 动态地图更新: 园区经常有绿化修剪、井盖维修。你的 3D 语义地图必须能实时识别这些变化,否则机器人会对着一个新挖的坑“视而不见”。
研发团队岗位需求
| 模块 | 岗位 | 主要职责 | 说明 |
|---|---|---|---|
| 🧠 感知集成 | 感知算法工程师 | 集成现成模型(YOLO / SAM / LiDAR模型),做多传感器融合 | 不训练,只做调优+部署 |
| 📍 定位导航 | SLAM工程师 | GNSS/IMU/LiDAR融合定位、地图使用 | 主要是工程优化 |
| 🛣️ 规划控制 | 规划控制工程师 | 路径规划 + 行为决策 + 控制 | 核心“开车能力” |
| 🤖 机器人系统 | ROS2工程师 | ROS2系统架构、节点管理、通信 | 系统集成核心 |
| 🔧 嵌入式 | 嵌入式工程师 | 底盘控制、驱动、传感器接入 | Linux/CAN/驱动 |
| 🚙 底盘控制 | 车辆控制工程师 | 电机控制、转向、刹车 | 与硬件强绑定 |
| 👁️ 视觉应用 | 视觉工程师 | OCR(面单识别)、简单视觉任务 | 用现成OCR模型 |
| ☁️ 云平台 | 云平台工程师 | 车队管理、OTA、任务调度 | 远程控制核心 |
| 🖥️ 后端 | 后端工程师 | 订单系统、调度系统、API | 支撑业务系统 |
| ⚙️ 运维 | DevOps工程师 | 部署、监控、日志 | 保障系统稳定 |
| 🔌 硬件 | 硬件工程师 | 主控板、传感器选型 | 传感器集成 |
| 🧩 结构 | 结构工程师 | 车体设计、防水防震 | 工业设计 |
| 🧪 测试 | 测试工程师 | 仿真 + 实车测试 | CARLA / Gazebo |
| 🛡️ 安全 | 安全工程师 | fail-safe、紧急制动 | 工程安全 |
| 📦 产品 | 产品经理 | 场景定义、路径规划规则 | 需求驱动 |
嵌入式工程师
🔧 嵌入式工程师(偏系统接入层)
核心任务:

打通“计算机 ↔ 车辆硬件”的通道

做什么:
Linux 驱动开发
CAN / UART / SPI 通信
传感器接入(雷达/摄像头/IMU)
电机控制器通信协议解析
ROS2 driver 节点封装
设备树 / 内核适配
关键词:

👉 “能不能连上、能不能读写数据”
底盘控制工程师
🚙 底盘控制工程师(偏控制算法层)
核心任务:

让车“按你想要的轨迹稳定运动”

做什么:
速度控制(PID)
转向控制(Ackermann模型)
制动控制
轨迹跟踪(Pure Pursuit / MPC)
车辆动力学建模
控制稳定性调优
关键词:

👉 “车开得稳不稳、准不准、抖不抖”
底盘控制难,不是因为数学难,而是因为它在控制一个“充满误差、延迟、非线性、不可重复”的真实物理系统。
| 维度 | 嵌入式工程师 | 底盘控制工程师 |
|---|---|---|
| 世界类型 | 数字系统 | 物理系统 |
| 问题形态 | 离散问题 | 连续问题 |
| debug方式 | 看log | 上车试 |
| 可预测性 | 高 | 低 |
| 出错成本 | 中 | 高(安全风险) |
| 心智负担 | 工程实现 | 系统调优 |